10小时数据+一段人手视频=?SkeLAM的零样本跨形态迁移
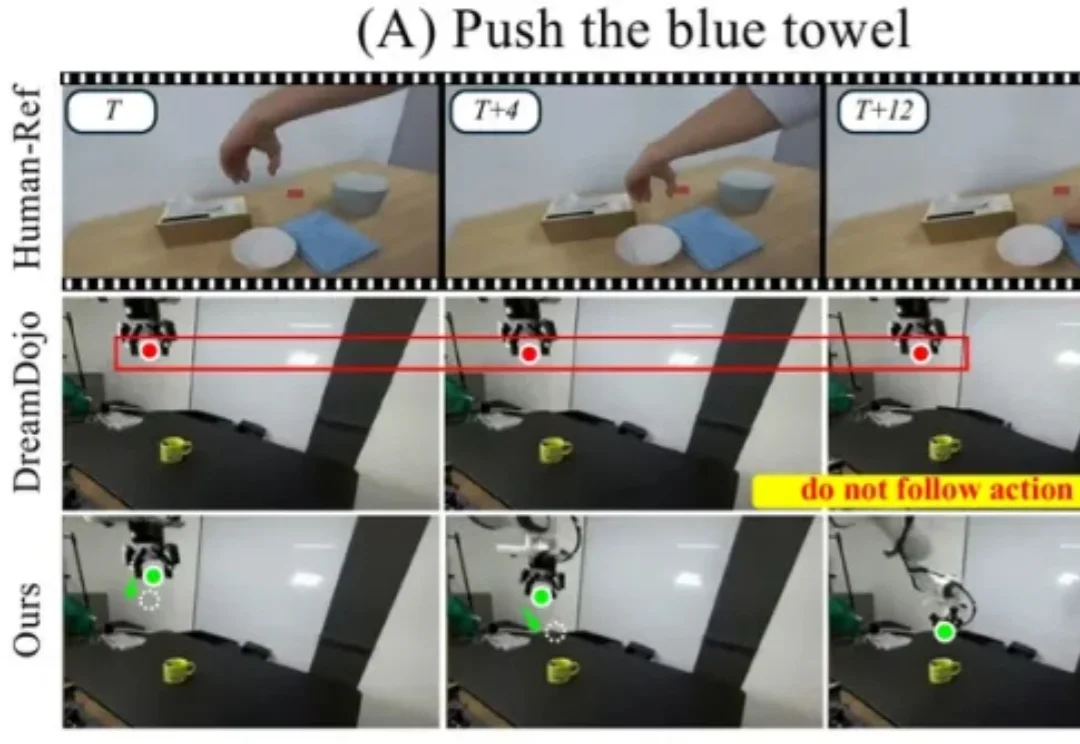
10小时数据+一段人手视频=?SkeLAM的零样本跨形态迁移基于预训练的 Cosmos-Predict2.5-2B,SkeLAM 使用总计约 10 小时的机器人交互数据进行训练。在人手到机器人的迁移实验中,输入换成人类演示,生成视频中的机械臂仍然呈现出与演示对应的运动方向。迁移时模型参数全部冻结,没有针对这些演示额外微调。
来自主题: AI技术研报
7394 点击 2026-10-27 13:46

 搜索
基于预训练的 Cosmos-Predict2.5-2B,SkeLAM 使用总计约 10 小时的机器人交互数据进行训练。在人手到机器人的迁移实验中,输入换成人类演示,生成视频中的机械臂仍然呈现出与演示对应的运动方向。迁移时模型参数全部冻结,没有针对这些演示额外微调。
从单幅图像恢复三维结构,到多视图场景建模、动态 4D 重建,再到机器人、自动驾驶、SLAM 与视频生成,如何让模型在不依赖逐场景优化的前提下,直接、高效地理解并重建三维世界,正在成为 3D 视觉领域的
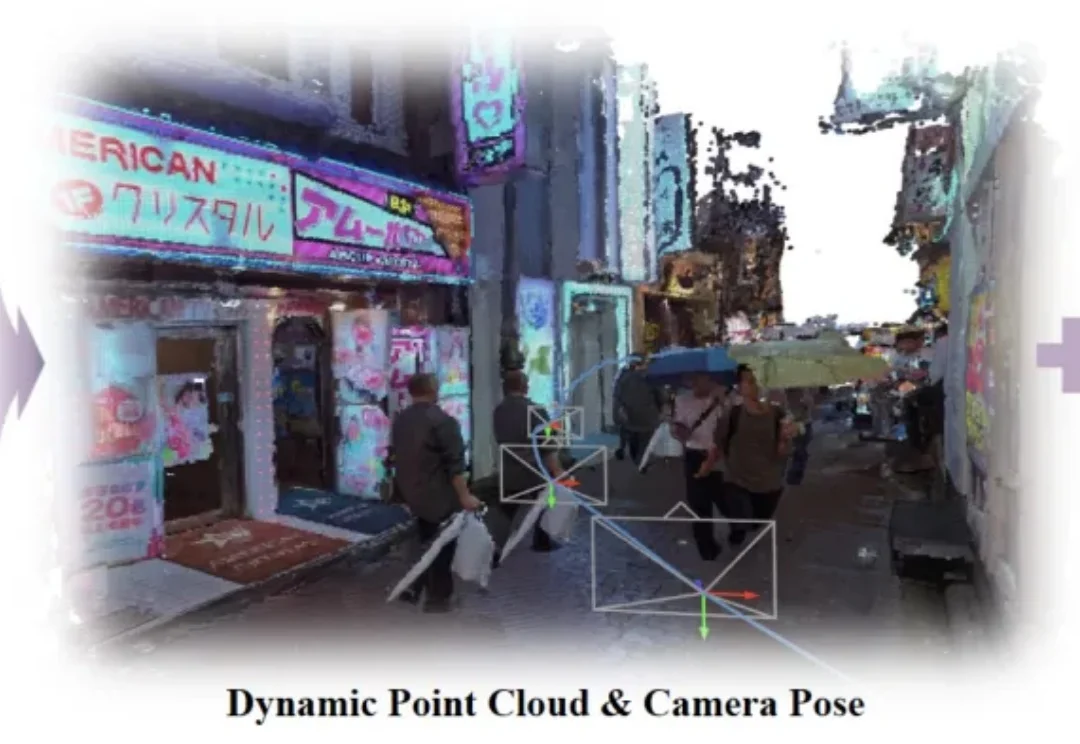
SLAM 在自动驾驶、机器人、AR/VR 乃至具身智能系统中都是至关重要的环节,它决定了算法能否在一个陌生环境中一边“看懂世界”,一边“知道自己在哪”。
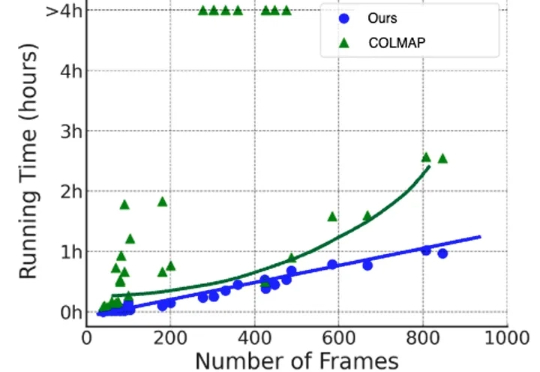
在三维重建、NeRF 训练、视频生成等任务中,相机参数是不可或缺的先验信息。传统的 SfM/SLAM 方法(如 COLMAP)在静态场景下表现优异,但在存在人车运动、物体遮挡的动态场景中往往力不从心,并且依赖额外的运动掩码、深度或点云信息,使用门槛较高,而且效率低下。
「即便最终赢家不是它,它也足够意义重大。」一位 LAM 产品经理这样评价 Manus AI 的行业价值。
据外媒 12 月 20 日消息,由华人创立的 AI 公司 rabbit 又获得了一笔千万美元的融资,这是他们近 2 个月所获得的第 3 笔融资。